Ein verspäteter Auftrag, ein kritischer Lagerbestand oder ein überschrittener Qualitätsgrenzwert ist für das Unternehmen mehr als eine zusätzliche Datenzeile. Solche Situationen erfordern eine fachlich eindeutige Nachricht, eine verlässliche Weitergabe und eine nachvollziehbare Reaktion. Business Events in Microsoft Fabric verbinden genau diese Ebenen: ein zentral beschriebenes Ereignis, unabhängig arbeitende Publisher und Consumer sowie operative Aktionen und historische Analyse. Entscheidend ist jedoch, die Funktion von einem gewöhnlichen Eventstream und einem geplanten Datenpipeline-Lauf abzugrenzen.
Was sind Business Events in Microsoft Fabric?
Ein Business Event ist ein fachlich relevantes Ereignis, auf das mehrere Systeme oder Teams reagieren können. Es beschreibt eine eingetretene Tatsache wie OrderDelayed, InventoryMovement oder PaymentFailed, nicht einfach jede technische Statusänderung. Während ein Rohdatenstrom Tausende Messwerte pro Minute transportiert, kennzeichnet ein Business Event die daraus abgeleitete Bedeutung: Ein Auftrag ist so weit verspätet, dass eine Reaktion erforderlich ist.
In Fabric werden Business Events im Real-Time hub sichtbar und können von verschiedenen Publishern erzeugt sowie von voneinander unabhängigen Consumern genutzt werden. Ein Publisher muss nicht wissen, ob später eine E-Mail verschickt, eine Funktion gestartet oder ein Dashboard aktualisiert wird. Diese Entkopplung ist der architektonische Vorteil: Änderungen am Empfängerkreis erfordern nicht automatisch Änderungen im Quellsystem.
Der Real-Time hub ist dabei die Entdeckungs- und Integrationsoberfläche; das Event Schema Set bündelt die fachlichen Verträge und Versionen. Die Schema Registry verwaltet die Struktur. Activator kann auf ein Ereignis reagieren und Prozesse anstoßen. Ein Eventhouse kann veröffentlichte Ereignisse automatisch für Abfragen und Dashboards speichern, wenn diese Option bei der Ereignisanlage aktiviert ist. Diese Komponenten erfüllen verschiedene Aufgaben und sollten nicht als austauschbare „Event-Plattform“ behandelt werden.
Für die Planung wichtig: Microsoft führt Business Events und Event Schema Registry grundsätzlich als allgemein verfügbar. Einzelne Dokumentationsseiten und ergänzende Funktionen tragen jedoch weiterhin Preview-Kennzeichnungen, insbesondere bei schema-aware Eventstream-Verarbeitung oder Teilen der Datenzugriffsverwaltung. Deshalb müssen Teams die konkret eingesetzten Funktionen und ihre regionalen Voraussetzungen separat prüfen, statt sich auf einen einzigen globalen Reifegrad zu verlassen.
Die Architektur: Vom Publisher zum fachlichen Ereignis
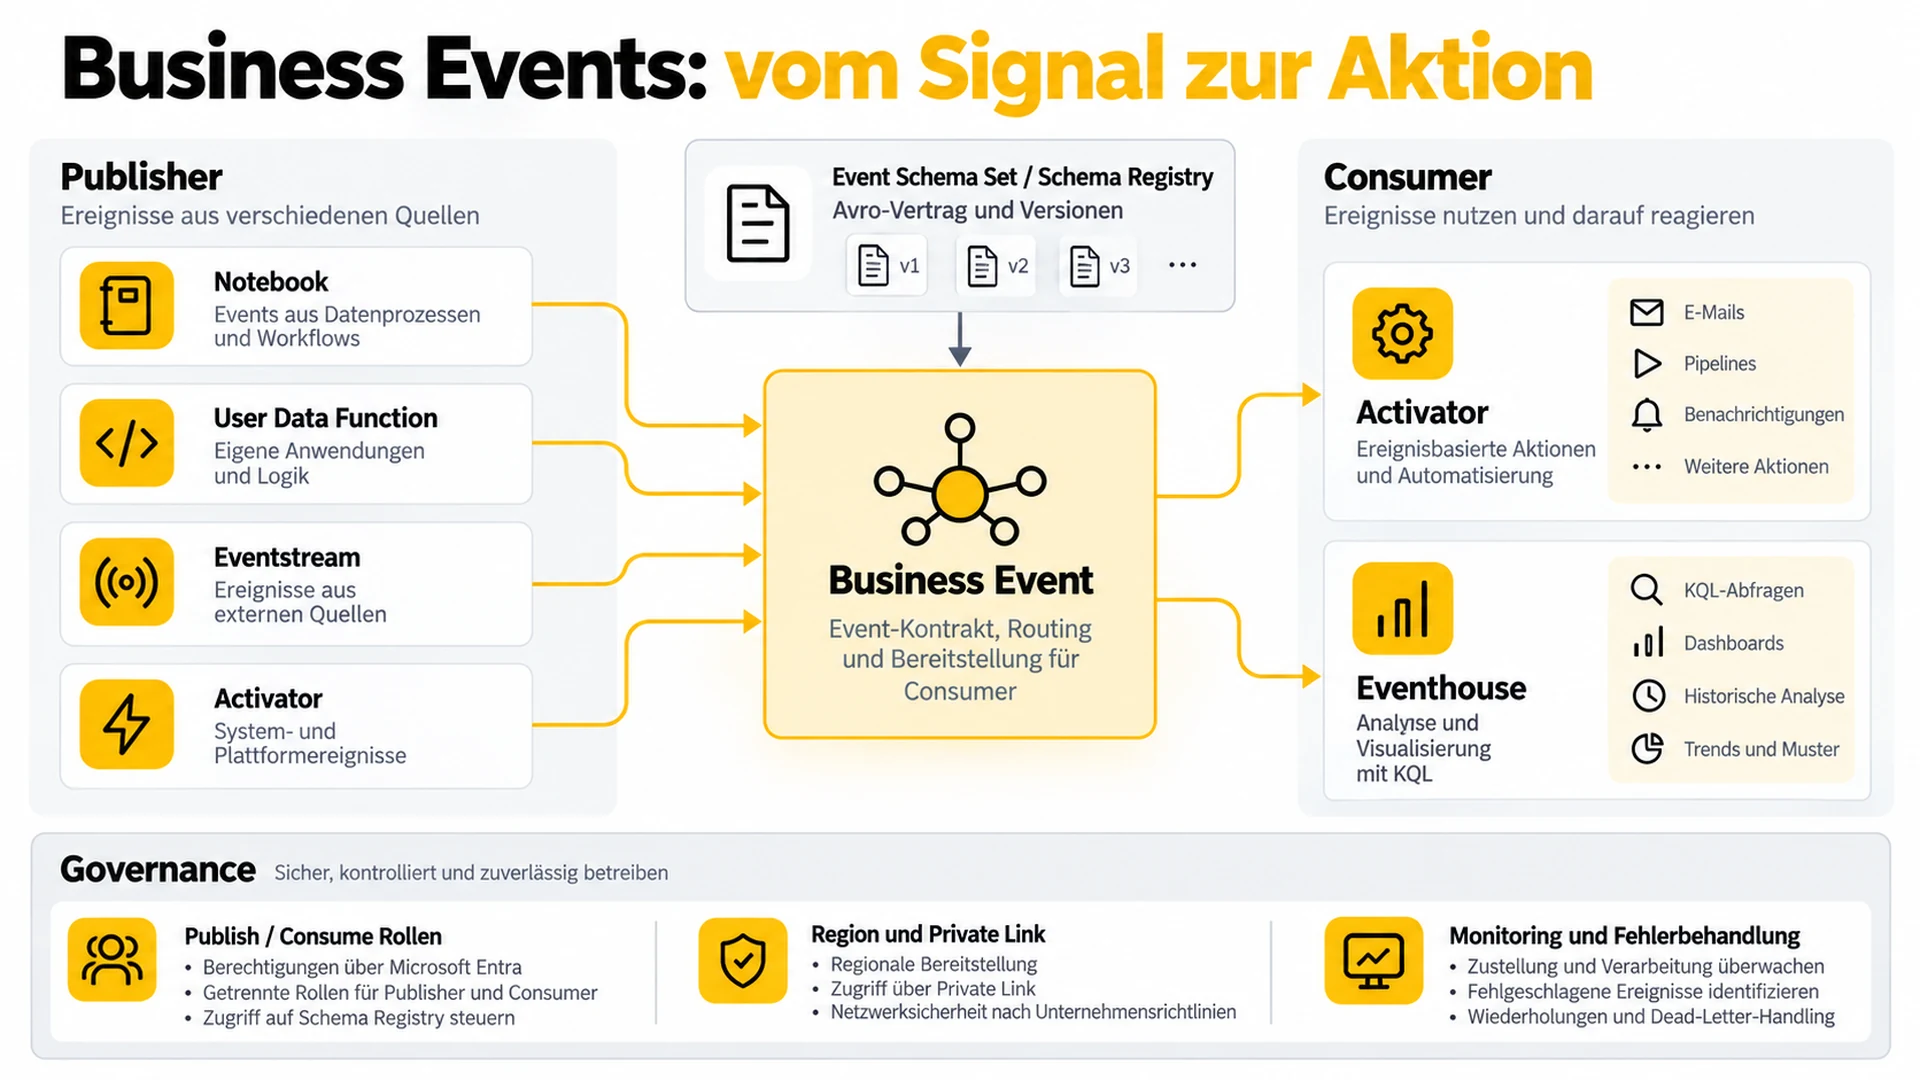
Die einfachste tragfähige Architektur trennt Ereigniserzeugung, Ereignisvertrag, Veröffentlichung und Verbrauch. Ein Notebook, eine User Data Function, ein passend konfigurierter Eventstream oder Activator erkennt eine relevante Situation. Ein registrierter Event-Typ, beispielsweise OrderDelayed, beschreibt, welche Felder ein gültiger Ereignis-Payload enthalten soll. Die registrierte Definition wird für Publisher und Consumer gemeinsam verwendet.
Nach dem Publish ist der Ereignistyp im Real-Time hub auffindbar. Activator kann ihn abonnieren und zum Beispiel eine Benachrichtigung senden oder eine freigegebene Fabric-Aktivität auslösen. Parallel kann Eventhouse die Ereignisse erfassen, sodass das Team später Häufigkeiten, Verzögerungen und Fehlermuster in einer KQL-Abfrage untersuchen kann. Für weitere Verarbeitungspfade kommt je nach unterstütztem Funktionsstand auch ein Eventstream als Consumer infrage.
Die Verantwortung der Komponenten trennen
Publisher: Erkennt die fachliche Bedingung und sendet das Ereignis. Er verantwortet die korrekten Nutzdaten, den Zeitpunkt der Erzeugung und eine eindeutige fachliche Ereignisidentität. Ein mehrfach gelaufener Notebook-Job darf nicht unkontrolliert denselben Geschäftsfall als neuen Vorgang ausgeben.
Event Schema Set und Schema Registry: Beschreiben Struktur, Typen, Versionen und organisatorische Zuständigkeit. Das Event Schema Set ist ein verwaltetes Fabric-Item; die Registry stellt die zentrale Wiederverwendbarkeit her. Die Registrierung allein ist jedoch kein universeller Filter, der automatisch jeden Rohdatenstrom bereinigt. Die tatsächliche Prüfung und Feldzuordnung hängt vom verwendeten Publisher, Eventstream-Verarbeitungspfad und Consumer ab.
Consumer: Trifft auf Basis des Ereignisses eine Entscheidung oder verarbeitet die Nachricht. Ein Activator-Consumer kann Benachrichtigungen und Aktionen anstoßen; Eventhouse dient der analytischen Speicherung. Mehrere Consumer dürfen unterschiedliche Ziele verfolgen, müssen aber jeweils mit Dubletten, verspäteter Zustellung und eigenen Fehlern umgehen können.
Owner: Definiert den fachlichen Sinn des Events, zulässige Änderungen am Schema, Berechtigungen und Eskalationsregeln. Ohne diese Verantwortung wird aus dem gemeinsamen Ereignisvertrag lediglich ein weiterer technischer Integrationspunkt.
Event Schema Registry und Avro: Der Vertrag vor dem Workflow
Die Schema Registry unterstützt Avro-Schemas und fasst sie in Event Schema Sets zusammen. Ein Avro-Schema beschreibt, wie ein Ereignis-Payload aufgebaut ist: Feldnamen, Datentypen und gegebenenfalls zusätzliche Beschreibungen oder Standardwerte. Mit derselben Definition können mehrere Publisher denselben Ereignistyp verwenden, ohne ihre eigenen Feldnamen und Datentypen zu erfinden.
Für ein Versandereignis genügt zu Beginn ein bewusst kleines Schema. Die operative Reaktion soll eine Bestellung erkennen, den Verzug bewerten und entscheiden können, ob eine Meldung ausgelöst werden muss. Kundennamen, E-Mail-Adressen oder vollständige Bestellpositionen gehören dafür nicht automatisch in das Event. Ein schlanker Vertrag reduziert Datenschutzrisiken und vermeidet unnötige Abhängigkeiten.
{
  "type": "record",
  "name": "OrderDelayed",
  "namespace": "datenwg.fulfillment.events",
  "fields": [
    {"name": "orderId", "type": "string"},
    {"name": "delayMinutes", "type": "int"},
    {"name": "reasonCode", "type": "string"},
    {"name": "severity", "type": "string"},
    {"name": "fulfillmentCenter", "type": "string"}
  ]
}
Beispielstatus: gültige Avro-Struktur als redaktioneller Entwurf; nicht gegen eine Fabric-Laufzeit ausgeführt.
Die fachliche Bedeutung gehört ebenfalls zur Vertragsdokumentation: Ist delayMinutes der Verzug gegenüber dem zugesagten Liefertermin oder der ursprünglichen Planung? Welche Werte darf severity annehmen? Wer entscheidet, ob ein reasonCode neu aufgenommen wird? Ohne diese Angaben können Publisher strukturell korrekte Daten liefern, die Consumer trotzdem falsch interpretieren.
Versionen sind kein automatischer Kompatibilitätsschutz
Änderungen an einem registrierten Schema erzeugen neue, fortlaufend nummerierte Versionen. Fabric prüft dabei nicht automatisch die Rückwärts- oder Vorwärtskompatibilität. Wer ein erforderliches Feld entfernt oder einen Datentyp ändert, kann vorhandene Publisher und Consumer brechen, selbst wenn die neue Version im Registry-Eintrag problemlos gespeichert wurde.
Ein belastbarer Änderungsprozess sieht deshalb so aus: Die fachlich verantwortliche Person beschreibt die Änderung; das Team prüft alle bekannten Publisher und Consumer; eine neue Schema-Version wird erstellt; Tests decken alte und neue Payloads ab; danach werden Publisher und Consumer kontrolliert umgestellt. Bei einem grundlegenden Bedeutungswechsel ist häufig ein neuer Ereignistyp besser als eine stille Änderung des alten Vertrags.
Die allgemeine Logik von Event Contracts ist auch für klassische Datenprodukte wichtig. Der Beitrag zu Data Contracts für BI und KI erklärt die übergreifende Rolle von Verantwortlichkeit, Schnittstellen und Datenqualität. Business Events übertragen diese Idee auf fachliche Ereignisse und die darauf folgenden Aktionen.
Business Events veröffentlichen: Notebook, UDF, Activator oder Eventstream?
Nicht jeder Publisher ist für denselben Anwendungsfall geeignet. Die Auswahl sollte dort beginnen, wo die fachliche Bedeutung erstmals zuverlässig feststeht. Wird der Verzug beim Ausführen einer berechneten Bedingung erkannt, ist ein Notebook oder eine User Data Function naheliegend. Besteht bereits ein kontinuierlicher Rohdatenstrom, kann ein Eventstream passende Daten filtern und in einen fachlichen Event-Typ überführen. Sind KPI- oder SQL-Schwellenwerte bereits in Activator definiert, kann Activator selbst ein Ereignis erzeugen.
Notebook und User Data Function für explizite Fachlogik
In einem Fabric-Notebook steht dafür die Schnittstelle notebookutils.businessEvents.publish() zur Verfügung; bei User Data Functions wird der passende Business-Events-Client verwendet. Beide Wege setzen einen registrierten Event-Typ sowie die erforderliche Publish-Berechtigung voraus. Die konkrete API-Signatur und das unterstützte Runtime-/Sprachmodell sind vor dem Einsatz zu prüfen.
Ein vereinfachtes Notebook-Beispiel für den bereits angelegten Schema-Vertrag:
notebookutils.businessEvents.publish(
    eventSchemaSetWorkspace="Fulfillment Workspace",
    eventSchemaSet="FulfillmentEvents",
    eventTypeName="OrderDelayed",
    eventData={
        "orderId": "SO-1842",
        "delayMinutes": 47,
        "reasonCode": "CARRIER_DELAY",
        "severity": "high",
        "fulfillmentCenter": "FC-WEST"
    },
    dataVersion="v1"
)
Beispielstatus: Schnittstellenstruktur fachlich abgeglichen, nicht in einer Fabric-Instanz ausgeführt. Workspace, Event Schema Set, Ereignistyp und Schema-Version müssen in der Zielumgebung tatsächlich existieren.
Eine UDF ist insbesondere dann interessant, wenn Geschäftslogik mehrfach aufgerufen werden soll. Sie sollte nicht jeden beliebigen Datenbankzugriff in ein Ereignis verwandeln. Publiziert wird eine eingetretene fachliche Tatsache, idealerweise nach erfolgreicher Validierung der zugrunde liegenden Entscheidung. Die Implementierung sollte einen klaren Umgang mit Fehlern, Retries und der Beziehung zum ursprünglichen Geschäftsprozess besitzen.
Activator und Eventstream für bestehende Signale
Activator kann unter unterstützten Bedingungen selbst als Publisher dienen, etwa wenn eine SQL-Abfrage, ein KQL-Ergebnis oder eine Kennzahl aus einem Dashboard einen definierten Schwellenwert überschreitet. Als Consumer kann Activator anschließend Ereignisse abonnieren und freigegebene Aktionen auslösen. Publisher und Consumer sind dabei unterschiedliche Rollen, auch wenn dasselbe Fabric-Produkt beide Aufgaben übernehmen kann.
Eventstream ist sinnvoll, wenn Rohereignisse erst gefiltert, angereichert oder strukturell zugeordnet werden müssen. Dafür werden Felder auf das Event-Schema gemappt und ein Business-Events-Ziel eingerichtet. Gerade diese schema- und eventtypbezogenen Funktionen besitzen teilweise abweichende Preview-Grenzen. Produktive Architekturen sollten daher den tatsächlich genutzten Eventstream-Connector und dessen Feature-Status einzeln validieren.
Business Events konsumieren: Activator, Eventhouse und Dashboards
Activator beantwortet die Frage „Was soll jetzt passieren?“ Eine Regel kann eingehende Business Events filtern, eine Bedingung prüfen und eine Aktion auslösen, etwa eine Teams-Nachricht oder den Start einer freigegebenen Funktion. Die Regel sollte eine fachliche Eskalation abbilden – nicht einfach jedes Ereignis an alle Empfänger schicken. Für eine Lieferverzögerung könnte eine Benachrichtigung erst bei hoher Priorität und längerem Verzug sinnvoll sein.
Das passende Rollenmodell ist wichtig: Die Person, die das Schema bearbeiten darf, benötigt nicht automatisch das Recht, das Event zu veröffentlichen oder als Consumer zu lesen. Für Publisher und Consumer sind eigene Data-Access-Rollen vorgesehen. Zudem unterscheiden sich die Möglichkeiten, Rollen über die Benutzeroberfläche und über APIs zu verwalten. Diese Grenzen sind Teil der Sicherheitsarchitektur, nicht ein reines Admin-Detail.
Eventhouse beantwortet die Frage „Was ist tatsächlich geschehen?“ Bei der Erstellung eines Business Events kann die Option zur Analyse im Eventhouse aktiviert werden; sie ist in der beschriebenen Standardkonfiguration vorausgewählt. Dann wird für das Ereignis eine eigene KQL-Tabelle angelegt. Diese speichert eingehende Ereignisse für nachträgliche Analysen und kann Basis eines Real-Time Dashboards sein. Das ist besonders nützlich, um wiederkehrende Verzögerungen nicht nur als einzelne Benachrichtigungen, sondern als Muster zu erkennen.
Eine einfache, rein lesende KQL-Auswertung kann so aufgebaut sein:
// Tabellenname an das tatsächlich angelegte Eventhouse anpassen
OrderDelayedEvents
| where ingestion_time() > ago(1d)
| summarize Ereignisse = count() by severity
| order by Ereignisse desc
Beispielstatus: KQL-Muster zur Aggregation; Tabellenname und Feldstruktur sind Platzhalter und wurden nicht in Fabric getestet.
Ob ein Eventhouse-Record dauerhaft für Audits oder Wiederholungen genutzt werden darf, hängt von der konkreten Retention-Konfiguration, Datenzugriffspolitik und dem Betriebsprozess ab. Eventhouse-Historie ist nicht gleichbedeutend mit einer garantierten Wiederholung derselben Geschäftsaktion. Das System muss zwischen „Ereignis gespeichert“ und „Consumer hat die Aktion erfolgreich abgeschlossen“ unterscheiden.
Berechtigungen, Regionen und Private Links früh prüfen
Business Events nutzen ein separates Data-Access-Modell für Publish und Consume. Workspace-Rollen steuern dagegen unter anderem den Zugriff auf das Event Schema Set. Daraus folgt: Wer im Workspace ein Schema sehen kann, darf nicht automatisch Ereignisse veröffentlichen oder empfangen. Standardmäßig gilt für die Event-Daten ein restriktives Berechtigungsmodell; Zugriffe müssen explizit erteilt werden. Die initiale Rolle des Erstellers erleichtert den Test, sollte aber nicht ungeprüft zum allgemeinen Betriebsmodell werden.
Die Rolle kann auf einzelne Ereignistypen oder ein Event Schema Set ausgerichtet sein; die Konfiguration muss den aktuellen API-/UI-Grenzen entsprechen. Bei der Planung von Service Principals und Managed Identities lohnt sich ein eigener Test. Insbesondere sollte man keine Unterstützung für Microsoft-Entra-Gruppen voraussetzen, wenn der konkret eingesetzte Zugriffsweg nur direkte Identitäten akzeptiert.
Auch die regionale Platzierung ist nicht symmetrisch. Ein Publisher darf Business Events grundsätzlich auch aus einer anderen Region veröffentlichen, sofern Netzwerk und Berechtigungen passen. Ein Consumer-Item wie Activator oder Eventstream muss für die Ereigniskonfiguration dagegen in derselben Region wie das Event Schema Set liegen. Wer diese Unterscheidung ignoriert, plant möglicherweise eine Architektur, die sich später nicht wie vorgesehen konfigurieren lässt.
Bei aktiviertem Workspace Private Link muss der Zugriff aus anderen Workspaces ebenfalls gesondert geprüft werden. Wird im Quell-Workspace öffentlicher Zugriff unterbunden, sind Publisher und Consumer aus anderen Workspaces unter Umständen nur über einen passenden Private-Link-Pfad erreichbar. Für einen Pilot reduziert ein gemeinsamer Workspace die Komplexität erheblich. Im Produktivdesign sollten dennoch zukünftige Domänengrenzen, Betriebsrollen und Sicherheitsanforderungen berücksichtigt werden.
Zustellgarantien: Duplikate, Reihenfolge und Wiederholung
Für Business Events gilt ein At-least-once-Zustellmodell. Eine Zustellung kann wiederholt werden; dieselbe fachliche Nachricht kann daher mehr als einmal beim Consumer eintreffen. Außerdem ist die Reihenfolge eingehender Ereignisse nicht garantiert. Wer aus einem mehrfach empfangenen OrderDelayed jedes Mal eine neue Eskalation startet, erzeugt doppelte Tickets, E-Mails oder sogar doppelte Folgeaktionen.
Die CloudEvents-Metadaten enthalten ein id und ein source. Die Kombination aus source und id dient als technische Identität für die Deduplizierung. Zusätzlich kann ein fachlicher Schlüssel – etwa Bestellnummer plus Ereignistyp plus definierter Zustandswechsel – helfen, semantisch identische Ereignisse zu erkennen, die aus einem fehlerhaften Publisher versehentlich mit unterschiedlichen technischen IDs gesendet wurden. Beide Ebenen dürfen nicht verwechselt werden.
Die Plattform wiederholt fehlgeschlagene Zustellversuche nur für ein begrenztes Zeitfenster. Danach ist eine eigene Fehler- und Wiederanlaufstrategie notwendig. Für kritische Folgeprozesse gehören deshalb Idempotenz, Monitoring und ein kontrollierter Nachbearbeitungsweg in das Design. Aus einer Preview-Liste oder einem Eventhouse-Datensatz allein lässt sich keine Exactly-once-Verarbeitung ableiten.
Eine einfache Regel für Consumer lautet: Erst die Ereignisidentität prüfen, dann eine transaktionssichere Entscheidung treffen und das Verarbeitungsergebnis mit derselben Identität protokollieren. Wenn eine Aktion erneut versucht wird, muss ein vorhandener Erfolg erkannt werden. Bei fehlgeschlagenen Aktionen sollte das Team eindeutig sehen können, ob ein Retry erforderlich, bereits erfolgt oder endgültig gestoppt ist.
Praxispilot: OrderDelayed vom Ereignis bis zur Reaktion
Ein Händler möchte Kundenservice und Logistik informieren, wenn eine Bestellung einen relevanten Lieferverzug erreicht. Bisher prüft ein geplanter Job regelmäßig die Auftragsliste und versendet eine Sammelmeldung. Künftig soll bei Eintritt der fachlichen Bedingung ein eindeutiges Ereignis entstehen, das verschiedene Empfänger unabhängig nutzen können. Für einen ersten Pilot reichen ein Event-Typ, ein Publisher und zwei Consumer.
Schritt 1: Geschäftliche Bedeutung festlegen
Der Logistik-Owner entscheidet, wann OrderDelayed erzeugt wird: etwa nach Überschreiten eines vereinbarten Verzugs, wenn der Auftrag noch nicht ausgeliefert ist. Die Schwelle darf im Pilot synthetisch gewählt werden. Entscheidend ist eine klare Definition: Bei welchem Zustandswechsel wird gesendet, wann nicht und wie wird eine erneute Bewertung behandelt? Eine Definition „immer wenn delayMinutes größer null ist“ wäre für viele Prozesse zu unspezifisch.
Schritt 2: Event Schema Set und Vertrag anlegen
Im Real-Time hub wird ein Ereignis mit einem Avro-basierten Vertrag angelegt. orderId, Verzögerung, Ursache, Priorität und Standort reichen für die ersten Tests. Der Owner wird dokumentiert, ebenso Schema-Version und Consumer-Abhängigkeiten. Für die Pilotphase werden keine personenbezogenen Nutzdaten benötigt. Die veröffentlichten Werte werden auf den Vertrag gemappt.
Schritt 3: Publish und Consume getrennt berechtigen
Die Publishing-Identität erhält gezielt Publish-Zugriff; die verarbeitenden Identitäten erhalten Consume-Zugriff. Der Zugriff auf Schema Set, Eventhouse und Activator wird separat geprüft. Publisher und Consumer werden zunächst im selben Workspace beziehungsweise in einer kompatiblen regionalen Konfiguration betrieben. Ein einmaliger erfolgreicher UI-Test ersetzt keine Prüfung der später verwendeten Service-Identität.
Schritt 4: Synthetische Testereignisse veröffentlichen
Für die erste Ende-zu-Ende-Prüfung kann die Funktion Publish sample event genutzt werden. Der Test-Payload muss die aktuellen Feldnamen und Datentypen einhalten. Anschließend werden Publisher- und Consumer-Preview verglichen. Die Vorschau zeigt nur eine begrenzte Anzahl aktueller Ereignisse und ist keine dauerhaft belastbare Audit-Historie.
Schritt 5: Reaktion und historische Analyse verifizieren
Ein Activator-Consumer sendet eine Benachrichtigung bei hoher Priorität. Der zweite Consumer nutzt – sofern aktiviert – die Daten im Eventhouse für die Analyse. Für jeden Testfall wird überprüft: Ist das Event beim Publisher sichtbar? Hat der Consumer es empfangen? Wurde eine Aktion tatsächlich ausgeführt? Taucht die Nachricht in der vorgesehenen KQL-Tabelle auf? Eine grüne Publisher-Anzeige allein beantwortet diese Fragen nicht.
Schritt 6: Fehlerfälle vor dem Rollout simulieren
Im Test werden dieselbe Nachricht mehrfach, eine bewusst fehlerhafte Schema-Version und ein temporär nicht verfügbarer Consumer durchgespielt. Das Team beobachtet, ob Benachrichtigungen doppelt entstehen, ob eine gescheiterte Aktion nachvollziehbar ist und wer eingreifen darf. Ein realistischer Pilot endet nicht beim ersten Erfolg, sondern mit einem dokumentierten Wiederanlaufweg und einer klaren Owner-Entscheidung für den nächsten Schritt.
Wann Business Events – und wann Eventstream oder Pipeline?
Business Events sind nicht die Antwort auf jede Datenbewegung. Ein fachliches Ereignis lohnt sich, wenn eine relevante Zustandsänderung mehrere unabhängige Reaktionen auslösen soll. Eventstream ist dagegen besonders geeignet, wenn kontinuierliche Rohdaten gefiltert, aggregiert oder zu anderen Zielen geroutet werden. Eine klassische Pipeline ist häufig einfacher, wenn definierte Verarbeitungsschritte planbar nacheinander ausgeführt werden und kein unmittelbares fachliches Signal erforderlich ist.
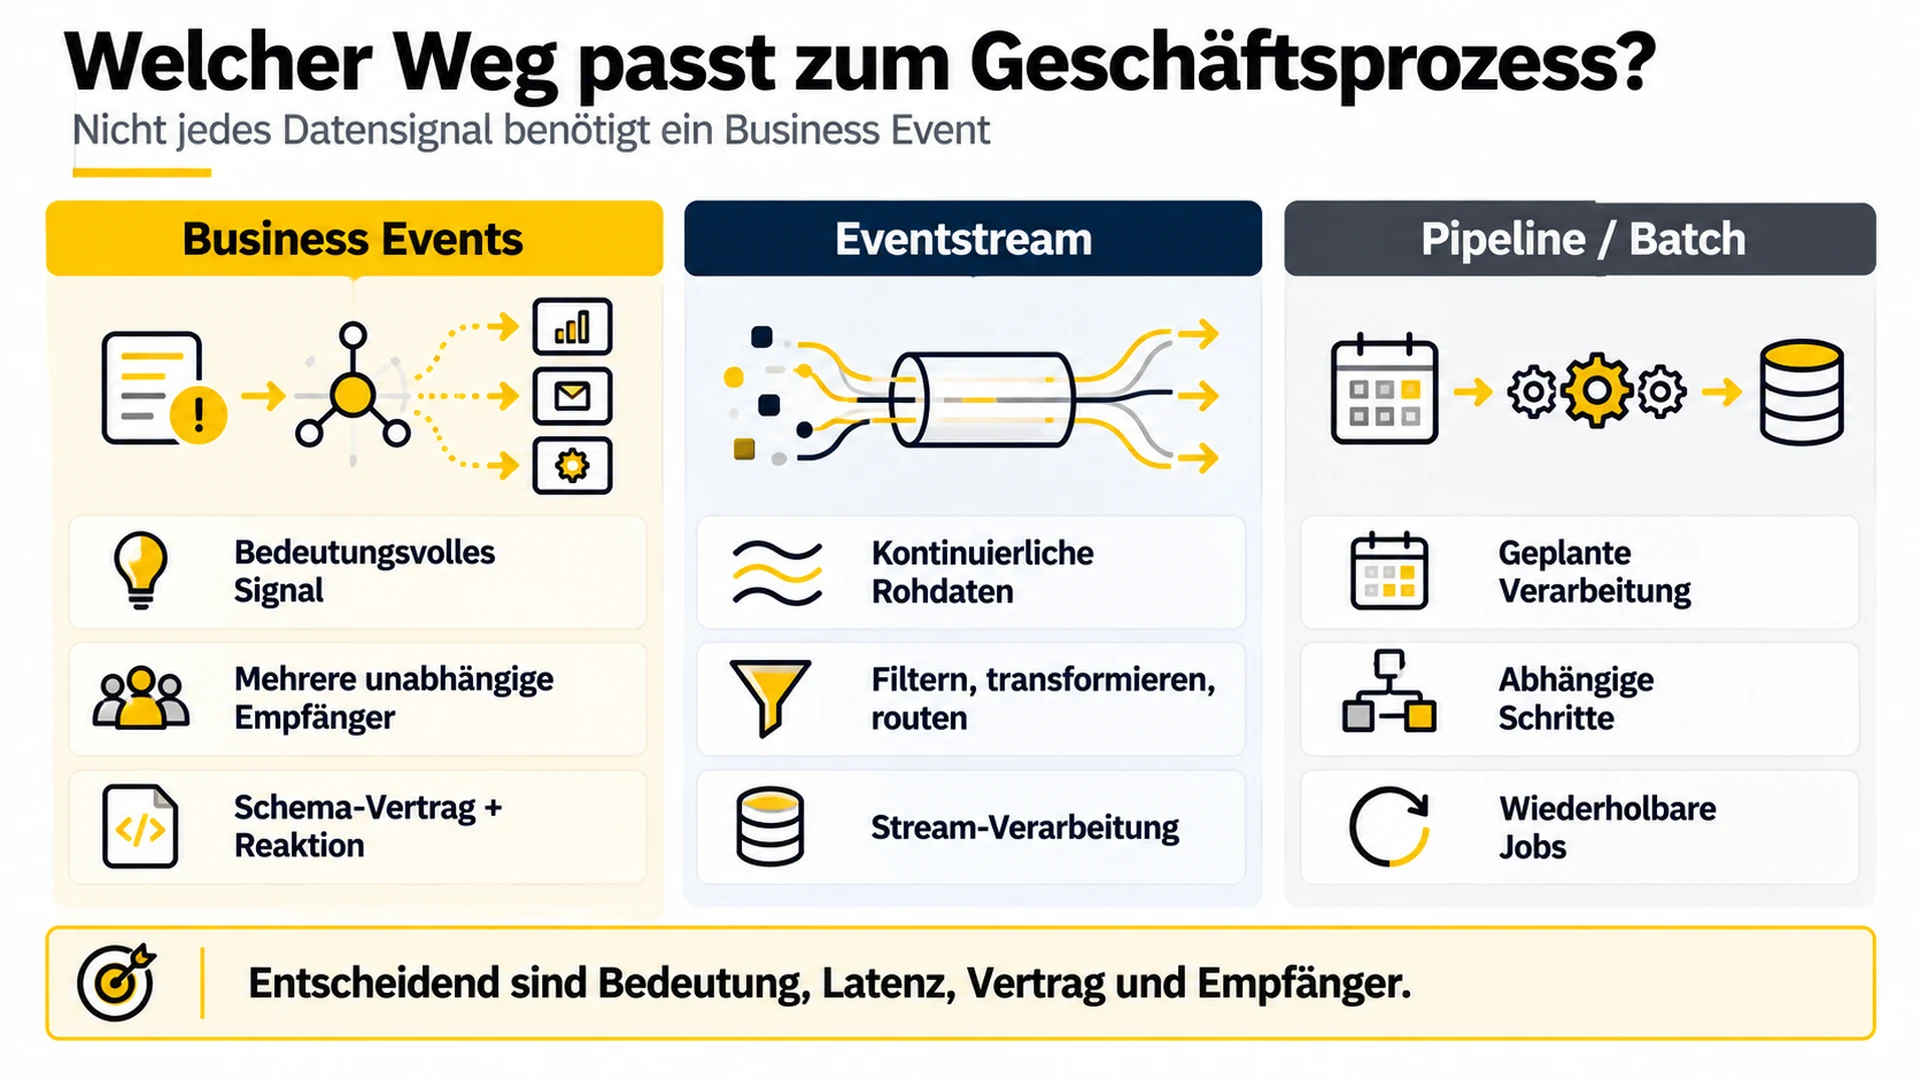
| Entscheidungsfrage | Business Event | Eventstream | Pipeline / Batch |
|---|---|---|---|
| Was wird transportiert? | Fachliche Tatsache mit definiertem Vertrag | Laufende Mess-, Status- oder Systemdaten | Geplanter Datenverarbeitungsschritt |
| Was ist der Hauptnutzen? | Unabhängige Reaktionen mehrerer Consumer | Kontinuierliche Transformation und Routing | Kontrollierte Ablauf- und Abhängigkeitssteuerung |
| Wann ist es eine gute Wahl? | Ein Zustandswechsel verlangt zeitnahe Aktion | Hohe Ereignisfrequenz und Stream-Verarbeitung | Planbare, wiederholbare Jobs |
| Was muss besonders geprüft werden? | Versionen, Publish/Consume, Duplikate, Region | Schema-/Connector-Reife, Durchsatz, Fehlerpfad | Laufzeiten, Trigger, Recovery und Abhängigkeiten |
Die Optionen schließen sich nicht aus. Ein Eventstream kann Rohdaten verarbeiten und daraus ein Business Event erzeugen. Ein Business Event kann wiederum über Activator eine Pipeline auslösen. Die richtige Architektur ist kein Entweder-oder, sondern eine bewusste Trennung zwischen Datenerfassung, fachlicher Bedeutung und operativer Reaktion.
Wer bereits automatisierte Fabric-Pipelines betreibt, sollte die Abgrenzung zum Operations Agent für Fabric Pipelines kennen: Ein Operations Agent beobachtet und unterstützt den Betrieb von Pipelines, während ein Business Event einen fachlich definierten Zustandswechsel kommuniziert. Beide Konzepte können zusammenwirken, haben aber nicht denselben Zweck.
Was kostet der Betrieb – und was muss überwacht werden?
Ein Business-Events-Pilot benötigt nicht zwingend ein großes neues Plattformprojekt. Er verbraucht aber reale Fabric-Ressourcen. Publisher-Ausführung, Eventhouse-Speicherung, KQL-Abfragen und ausgelöste Aktionen können zusätzliche Last erzeugen; die tatsächlichen Kosten hängen von den verwendeten Items, Kapazitäten und Laufmustern ab. Eine allgemeine Aussage „Business Events sind kostenlos“ wäre genauso unbrauchbar wie eine pauschale CU-Kalkulation ohne Messdaten.
Die ersten Betriebskennzahlen sind überschaubar: Anzahl erzeugter Events, Anzahl sichtbarer und verarbeiteter Events, fehlgeschlagene Publish-Versuche, Anteil mehrfach zugestellter Ereignisse, End-to-End-Latenz bis zur Aktion und offene Fehlerfälle. Bei aktiviertem Eventhouse kommen Datenvolumen, Aufbewahrung und regelmäßige Abfragen hinzu. Ein alarmierter Consumer ist nicht automatisch ein erfolgreich abgeschlossener Geschäftsprozess.
Zur Dimensionierung sollten außerdem die konkreten Servicelimits berücksichtigt werden. Ein Event-Payload ist begrenzt; die Preview zeigt nur einen kleinen Ausschnitt der letzten Ereignisse. Auch Filter- und Eventtyp-Grenzen pro Listener können das Design beeinflussen. Größere Datenpakete gehören daher nicht vollständig in den Payload: Oft genügt eine Ereignisidentität und eine Referenz, über die ein autorisierter Consumer bei Bedarf weitere Details abruft.
Für den Produktionsbetrieb empfiehlt sich ein einfacher Incident-Ablauf: fachlichen Fall identifizieren, Publisher-Erfolg und Event-ID prüfen, Consumer-Subscription und Data-Access-Rolle kontrollieren, Netzwerk/Region abgleichen, Aktionsergebnis prüfen und einen autorisierten Retry dokumentieren. Nur wenn dieser Weg für das Betriebsteam nachvollziehbar ist, verbessert die Ereignisarchitektur tatsächlich die Reaktionsfähigkeit.
Governance und Änderungen ohne zusätzliche Bürokratie
Der häufigste Fehler ist nicht eine komplizierte API, sondern ein unklarer Owner. Wer darf OrderDelayed umbenennen? Wer entscheidet, ob ein neues severity-Feld zwingend wird? Wer trägt die Verantwortung, wenn ein Activator-Workflow verspätet oder doppelt reagiert? Diese Fragen sollten vor dem Produktiveinsatz beantwortet sein, müssen aber nicht in ein großes neues Gremium münden.
Für einen pragmatischen Einstieg reichen ein Event-Katalog mit Owner, Schema-Version und Zweck, eine kurze Liste der Publisher und Consumer sowie drei dokumentierte Freigabeentscheidungen: Änderung des Vertrags, Erweiterung des Empfängerkreises und Aktivierung einer neuen geschäftswirksamen Aktion. Ein eigener Prüfpfad gehört dazu, wenn Regeln Finanztransaktionen, personenbezogene Daten oder andere besonders kritische Prozesse beeinflussen.
Die technische Versionierung und kontrollierte Bereitstellung lassen sich in das bestehende Fabric-ALM-Konzept einordnen. Wichtig ist, Schema-Sets, Publisher und Consumer nicht blind gemeinsam auszurollen: Änderungen an einem Event-Vertrag können unabhängig von einzelnen Workspaces oder Jobs wirken. Der bestehende Leitfaden zu Microsoft Fabric CI/CD liefert hierfür den übergeordneten Entwicklungs- und Freigaberahmen.
Fazit: Ein Business Event ist ein Vertrag, keine neue Datenpipeline
Business Events entfalten ihren Nutzen, wenn die fachliche Bedeutung klarer ist als die technische Implementierung. Schema Registry und Event Schema Sets stellen die gemeinsame Struktur bereit; Publisher melden relevante Ereignisse; Activator und weitere Consumer setzen sie in Reaktionen um; Eventhouse macht historische Muster analysierbar. Für die Unternehmenspraxis sind dabei besonders vier Dinge entscheidend: eindeutige Verträge, explizite Rechte, nachvollziehbare Fehlerbehandlung und ehrliche Grenzen bei regionalen sowie Preview-Funktionen.
Ein erster Pilot sollte bewusst klein beginnen. Ein gut definierter Ereignistyp mit zwei geprüften Consumern ist wertvoller als ein breites Echtzeitprogramm ohne Ownership, Idempotenz und Betriebsnachweis. Erst wenn der fachliche Nutzen und die End-to-End-Zuverlässigkeit nachvollziehbar sind, lohnt sich die Ausweitung auf weitere Domänen.
Nächste Schritte: Ein Business-Events-Pilot mit klarer Entscheidung
Wähle zunächst einen kritischen, aber überschaubaren Anwendungsfall: beispielsweise Lieferverzug, Qualitätsabweichung oder einen relevanten Bestandszustand. Definiere den Ereignisvertrag, baue einen Publisher und zwei Consumer, teste die drei wichtigsten Fehlerfälle und messe die tatsächliche Reaktionszeit. Darauf lässt sich fundiert entscheiden, ob Business Events, Eventstream und bestehende Pipelines gemeinsam ein tragfähiges Betriebsmodell ergeben. Wenn die Pilotarchitektur, Rollen und Fabric-Voraussetzungen abgestimmt werden sollen, bietet der Microsoft Fabric Kick Start einen passenden Einstieg.