Fabric Data Agent API & SDK: Automatisierung, CI/CD und MCP

Aktualisiert: 27. Aug.
Wer einen Fabric Data Agent produktiv betreibt, stößt früher oder später an dieselbe Grenze: Im Portal lässt er sich komfortabel bauen, aber kaum kontrolliert versionieren, testen oder zwischen Umgebungen bewegen. Mit der öffentlichen Fabric Data Agent API und dem Python SDK ändert sich das – nicht, weil sich Agents jetzt auch per Code erstellen lassen, sondern weil sie sich zunehmend wie andere Software- und Datenartefakte behandeln lassen: versionierbar, testbar, deploybar, kontrolliert konsumierbar. Wer diesen Unterschied versteht, verschiebt seinen Blick vom Bauen eines Agents zum Betreiben eines Agents.
Dabei müssen fünf Ebenen sauber auseinandergehalten werden: REST API und SDK verwalten den Agent, Git und Deployment Pipelines organisieren seinen Lifecycle, Evaluation prüft die Antwortqualität, die Data-Agent-Runtime steuert Orchestrierung und Query Generation – und MCP stellt den veröffentlichten Agent für Apps und andere Agents bereit.
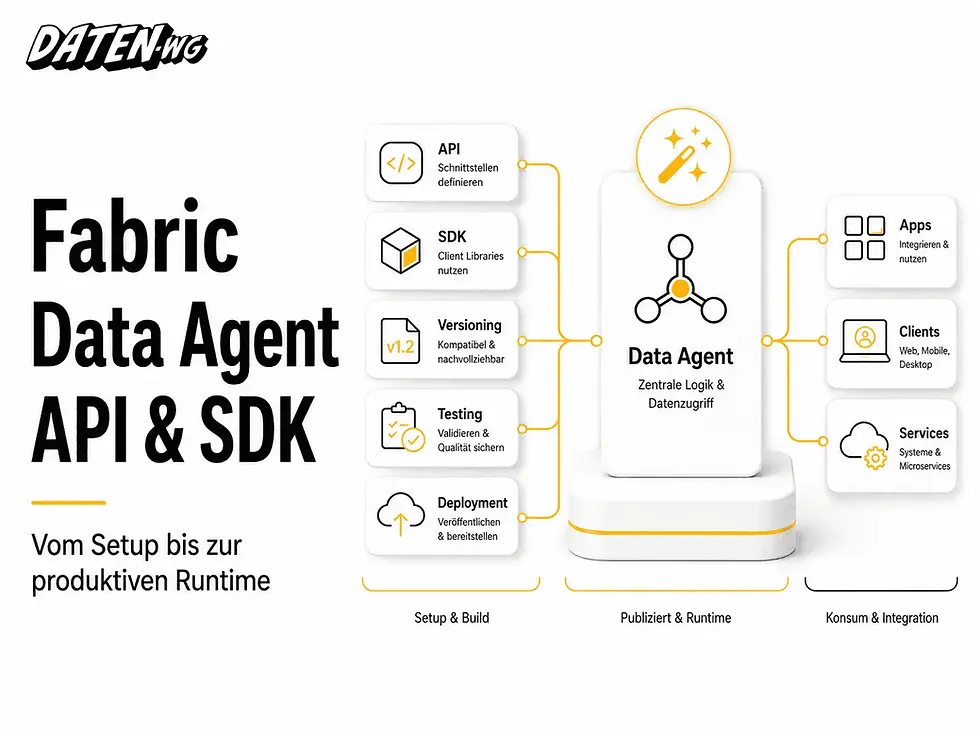
Fabric Data Agent API, SDK, Runtime und MCP im Vergleich
API, SDK und MCP lösen unterschiedliche Aufgaben. Wer sie in einen Topf wirft, baut schnell eine unnötig komplizierte Architektur.
Baustein | Hauptaufgabe | Typischer Einsatz |
Fabric REST API | Data-Agent-Artefakt verwalten | Automation, Plattformintegration, CI/CD |
Python SDK | Management per Python vereinfachen | Notebooks, Entwickler-Workflows, Skripte |
Git Integration | Konfiguration versionieren | Reviews, Branching, Änderungsverfolgung |
Deployment Pipelines | Änderungen zwischen Umgebungen transportieren | Dev → Test → Prod |
Evaluation | Antwortqualität automatisiert prüfen | Regressionstests, Release-Gates |
Data Agent Runtime | Orchestrierung, Planung, Query Generation | Standard Runtime (GA) / Preview Runtime (Preview) |
MCP Endpoint | veröffentlichten Agent konsumieren | Apps, AI Agents, MCP-Clients |
Microsoft beschreibt den Python SDK ausdrücklich als Management-Plane-Werkzeug. Er kann Data Agents erstellen, Datenquellen konfigurieren, Instructions und Example Queries verwalten und einen Agent veröffentlichen. Die Runtime ist davon getrennt: Nach dem Publishing wird der Data Agent über seinen MCP-Endpunkt angesprochen.
Diese Trennung ist ein zentraler Architekturpunkt. Ein Deployment-Prozess benötigt Rechte, um einen Agent zu verändern. Eine Anwendung, die später Fragen an diesen Agent stellt, braucht diese Fähigkeiten nicht.

Was die Fabric Data Agent REST API ermöglicht
Für Fabric Data Agents existieren eigene v1-Endpunkte der Fabric REST API. Unterstützt werden unter anderem Create, Get, List, Update, Delete und Publish sowie das Lesen und Aktualisieren der öffentlichen Definition eines Data Agents.
Diese Definition ist besonders interessant für automatisierte Prozesse. Microsoft bildet Data-Agent-Konfigurationen strukturiert als JSON ab. Dazu gehören unter anderem Stage-Konfigurationen, Datenquellen, AI Instructions und Few-Shot-Beispiele. Für veröffentlichte Agents existieren zusätzliche Published-Konfigurationen und Publish-Informationen. Genau das ist die Voraussetzung dafür, Änderungen nachvollziehbar zu machen und in etablierte Engineering-Prozesse einzubinden.
Der Python SDK macht die API praktikabler
Wer nicht direkt mit REST Requests und Item Definitions arbeiten möchte, kann den Fabric Data Agent Python SDK einsetzen. Das Paket fabric-data-agent-sdk lässt sich sowohl in Fabric Notebooks als auch – mit entsprechender Authentifizierung – außerhalb von Fabric nutzen. Der SDK befindet sich aktuell noch in Preview.
Ein stark vereinfachter Management-Workflow sieht beispielsweise so aus:
agent = create_data_agent(...)
agent.update_settings(...)
agent.add_staging_datasource(...)
agent.publish_staging(...)
Der Code ist nicht der eigentliche Mehrwert. Interessant wird der SDK dort, wo Vorgänge wiederholbar werden müssen.
Wenn ein Team einen einzigen Data Agent ausprobiert, ist das Portal häufig vollkommen ausreichend. Müssen dagegen mehrere Agents nach denselben Standards aufgebaut, über verschiedene Umgebungen verteilt oder regelmäßig aktualisiert werden, gewinnt der programmatische Ansatz deutlich an Wert.
Seit 26.08.2026: Assistants-Integrationen sind ein Migrationsfall
Beim ursprünglichen Erscheinen dieses Artikels am 18. August stand eine wichtige Frist noch bevor. Inzwischen ist sie verstrichen: Direkte Fabric-Data-Agent-Integrationen auf Basis der OpenAI Assistants API mussten bis zum 26. August 2026 auf den unterstützten neuen Zugriffspfad migriert werden. Parallel wurde im Fabric Data Agent SDK ein Responses-basierter Query-Client eingeführt; für veröffentlichte Data Agents ist MCP die dokumentierte Consumption-Schnittstelle.
Wichtig ist die Trennung: Management-Code über REST API oder SDK bleibt grundsätzlich bestehen. Betroffen ist der Abfragepfad. Bestehender Code mit älteren Assistants-/Threads-/Runs-Aufrufen sollte deshalb gezielt geprüft und auf den neuen Responses- beziehungsweise MCP-basierten Zugriff umgestellt werden.
MCP ist die Consumption-Schnittstelle des veröffentlichten Data Agents
Nach dem Publishing kann ein Fabric Data Agent als MCP Server genutzt werden. Der veröffentlichte Agent stellt dabei ein einzelnes MCP-Tool bereit, das kompatible Clients, eigene Anwendungen und andere AI Agents aufrufen können. MCP ist damit die Consumption-Schnittstelle; die interne Data-Agent-Runtime bleibt davon getrennt.
Der MCP-Endpunkt ist allerdings kein gewöhnlicher REST-Chat-Endpunkt. Ein Client muss den MCP-Ablauf unterstützen: Verbindung initialisieren, verfügbare Tools ermitteln und anschließend das entsprechende Tool aufrufen. Ein MCP SDK kann diese Kommunikation abstrahieren.
Das grenzt Fabric Data Agents auch vom Remote Power BI MCP Server ab. Remote Power BI MCP stellt einen Zugriffspfad auf Power-BI-Semantikmodelle bereit. Ein Fabric Data Agent ist dagegen ein eigenes, konfigurierbares Fabric-Artefakt mit einem darüberliegenden fachlichen Agent-Layer.
Standard oder Preview Runtime wird zur Betriebsentscheidung
Microsoft unterscheidet inzwischen zwischen einer Standard Runtime und einer Preview Runtime für Fabric Data Agents. Die Standard Runtime ist GA und für neue Agents der stabile Default; die Preview Runtime erhält neue Orchestrierungs-, Planungs- und Query-Generation-Verbesserungen früher.
Für Dev/Test/Prod-Architekturen sollte die Runtime-Auswahl deshalb als Teil der getesteten Agent-Konfiguration behandelt werden. Preview Runtime zuerst in Test evaluieren; Standard Runtime für produktive Agents bevorzugen, wenn Stabilität wichtiger ist als der frühestmögliche Zugriff auf neue Verbesserungen.
Git macht Data-Agent-Konfiguration nachvollziehbar
Fabric Data Agents lassen sich in die Git Integration von Microsoft Fabric einbeziehen. Die Data-Agent-Konfiguration wird dabei in strukturierten Dateien abgelegt. Versionierbar sind unter anderem Schemaauswahl, AI Instructions, Data Source Instructions und Example Queries. Source Control für Data Agents befindet sich aktuell noch in Preview.
Das ist insbesondere bei Instructions relevant. Eine scheinbar kleine Änderung kann beeinflussen, welche Datenquelle ein Agent auswählt oder wie er eine fachliche Frage interpretiert.
was geändert wurde,
wer eine Änderung vorgenommen hat,
welche Version vorher funktionierte,
welche Änderungen gemeinsam reviewed wurden.
Damit wird ein Data Agent noch nicht automatisch zu „Software as Code“. Aber seine Konfiguration wird deutlich besser beherrschbar.
Deployment Pipelines bringen Dev, Test und Prod zusammen
Fabric unterstützt für Data Agents auch Deployment Pipelines. Microsoft beschreibt dabei explizit den Weg von einem Development Workspace über Test bis in einen Production Workspace. Änderungen können vor der Promotion geprüft und anschließend gezielt in die nächste Stufe übertragen werden.
Ein produktionsnaher Ablauf kann damit so aussehen: Entwickeln → Git Commit → Review → Test Workspace → Evaluation → Production → Publish.
Zusätzlich können Azure DevOps Pipelines zusammen mit der Fabric CLI für automatisierte CI/CD-Prozesse eingesetzt werden. Für größere Synchronisationsszenarien dokumentiert Microsoft außerdem Preview-APIs zum Import und Export von Item Definitions in Batches.
CI/CD ohne Qualitätstest reicht nicht
Ein Data Agent kann technisch erfolgreich deployed werden und trotzdem schlechtere Antworten liefern als zuvor. Genau deshalb gehört die Antwortqualität in den Release-Prozess.
Microsoft bietet über den Fabric Data Agent SDK eine programmatische Evaluation an. Teams definieren dafür Fragen mit erwarteten Antworten als Ground Truth und lassen den Agent automatisiert dagegen testen. Die Evaluation befindet sich aktuell in Preview.
Für einen Finance-Agent könnten beispielsweise zwanzig fest definierte Fragen zu Umsatz, Forecast, Marge und Plan-Ist-Abweichungen Teil des Evaluationssets sein.
Nach einer Änderung an Instructions oder Datenquellen wird nicht nur geprüft, ob der Agent technisch erreichbar ist. Es wird auch geprüft, ob bekannte Geschäftsfragen weiterhin korrekt beantwortet werden.
Wie stark die Qualität von einem sauber vorbereiteten semantischen Modell abhängt, zeigt auch die Daten-WG-Einordnung zu AI-ready Semantic Models.
Service Principals ermöglichen automatisierte Runtime-Szenarien
Veröffentlichte Fabric Data Agents können inzwischen auch mit einer Service-Principal-Identität aufgerufen werden. Microsoft positioniert dies ausdrücklich für Automation, Background Services, eigene Anwendungen und CI/CD-nahe Szenarien. Die Funktion befindet sich noch in Preview.
Der Service Principal benötigt Zugriff auf den Workspace und explizite Leserechte auf die Datenquellen des Agents. Die Abfragen laufen unter dieser Identität. Managed Identities werden für die Data-Agent-Authentifizierung aktuell nicht unterstützt; auch Service Principals in Verbindung mit KQL-Datenbanken sind derzeit eingeschränkt.
Hinweis zum Dokumentationsstand: Microsofts spezifische Runtime-/Service-Principal-Dokumentation beschreibt diese Nutzung, während ältere ALM-Hinweise restriktiver formuliert sind. Für produktive Szenarien sollte der konkrete Authentifizierungsweg deshalb mit dem verwendeten Datenquellentyp getestet werden.
Für Power BI Semantic Models gilt grundsätzlich das bestehende Berechtigungsmodell. Microsoft dokumentiert Read als ausreichend für Agent-Abfragen; RLS und CLS bleiben dabei wirksam.
Wann lohnt sich API-Automatisierung?
Nicht jedes Fabric-Data-Agent-Projekt braucht sofort Git, Python SDK und eine dreistufige Deployment Pipeline. Bei einem ersten explorativen Pilot mit einem Agent und einem kleinen Team kann die Fabric-Oberfläche der sinnvollere Weg sein. Zusätzliche Automatisierung würde dort vor allem Komplexität schaffen.
Der Aufwand lohnt sich stärker, sobald mindestens einige dieser Bedingungen erfüllt sind:
mehrere Data Agents werden betrieben,
Dev-, Test- und Produktionsumgebungen müssen getrennt werden,
Instructions ändern sich regelmäßig,
Änderungen benötigen Reviews,
Releases müssen nachvollziehbar sein,
Regressionstests sollen automatisiert laufen,
Anwendungen greifen ohne interaktiven Benutzer auf Agents zu.
Dann wird aus einem Agent-Experiment zunehmend ein Plattform- und Betriebsproblem.
Die Grenzen bleiben wichtig
Fabric Data Agents selbst und die Standard Runtime sind inzwischen allgemein verfügbar. Das bedeutet aber nicht, dass jeder Baustein dieses Betriebsmodells denselben Reifegrad besitzt: Python SDK, MCP Server, Source Control, Evaluation und die Preview Runtime bleiben weiterhin Preview.
Auch programmatische Verwaltung löst keine fachlichen Qualitätsprobleme. Ein sauber deployter Agent mit widersprüchlichen Kennzahlen bleibt ein schlechter Agent. Wer zunächst verstehen möchte, welche Rolle Datenquellen, Semantik und Governance grundsätzlich spielen, findet die Einordnung unter Fabric Data Agents.
Der Creator Agent für Fabric Data Agents löst wiederum eine andere Aufgabe: Er unterstützt beim Erzeugen und Verbessern von Konfigurationen. API, Git und CI/CD sorgen anschließend dafür, diese Konfiguration kontrolliert zu verwalten.
Fazit: Data Agents bekommen einen echten Lifecycle
Die Fabric Data Agent API ist vor allem deshalb interessant, weil sie den Charakter von Data Agents verändert. Es geht nicht mehr ausschließlich darum, einen Agent im Portal zu konfigurieren und anschließend Fragen zu stellen. Mit REST API, Python SDK, Git Integration, Deployment Pipelines und programmatischer Evaluation entsteht schrittweise ein belastbarerer Lifecycle.
REST API und SDK bilden die Management Plane. Git und Pipelines steuern Änderungen. Evaluation bildet das Quality Gate. Die Data-Agent-Runtime übernimmt Orchestrierung, Planung und Query Generation; MCP ist die Consumption-Schnittstelle des veröffentlichten Agents. Für Teams, die nur einen ersten Agent ausprobieren, ist diese Architektur möglicherweise noch zu groß. Wer Data Agents dagegen langfristig in produktiven Analytics-Landschaften einsetzen möchte, sollte genau diese Trennung früh berücksichtigen.
Denn die entscheidende Frage lautet dann nicht mehr nur: „Kann der Agent unsere Daten beantworten?“ Sondern auch: „Können wir nachvollziehen, testen und kontrollieren, was sich an diesem Agent verändert?“
Der nächste sinnvolle Schritt
Wer Fabric Data Agents vom Pilot in einen kontrollierten Betrieb bringen möchte, sollte Architektur, Datenquellen, Berechtigungen, Testfälle und Deployment gemeinsam betrachten. Die Daten-WG unterstützt dabei, Fabric-Architektur und Betriebsmodell gemeinsam einzuordnen – vom abgegrenzten Pilot bis zu ALM, Governance und produktiver Integration.
Die Daten-WG unterstützt euch mit:
Data Strategy Check – um Datenprodukte, AI Readiness, Governance und Verantwortlichkeiten ganzheitlich einzuordnen
Consulting Abo – für kontinuierliche Unterstützung bei Modellpflege, Tests, Governance und produktivem Betrieb
Microsoft Fabric Kick Start – für einen praxisnahen Einstieg in Architektur, Zielbild und einen ersten KI-gestützten Analytics-Use-Case
FAQ zur Fabric Data Agent API
Gibt es eine REST API für Fabric Data Agents?
Ja. Microsoft Fabric stellt eigene v1-REST-Endpunkte für Data Agents bereit. Damit lassen sich Data Agents unter anderem erstellen, lesen, aktualisieren, löschen und veröffentlichen sowie ihre Definitionen abrufen und verändern.
Was ist der Unterschied zwischen REST API und Python SDK?
Die REST API ist die zugrunde liegende öffentliche Management-Schnittstelle. Der Python SDK abstrahiert diese Funktionen für Python-basierte Workflows und vereinfacht das Erstellen, Konfigurieren und Veröffentlichen von Data Agents. Der SDK befindet sich aktuell in Preview.
Wird ein Data Agent über die REST API abgefragt?
REST API und Runtime sollten getrennt betrachtet werden. Für veröffentlichte Data Agents positioniert Microsoft den MCP-Endpunkt als Runtime- und Consumption-Schnittstelle.
Unterstützen Fabric Data Agents CI/CD?
Ja. Data Agents unterstützen Git Integration und Fabric Deployment Pipelines. Damit können Konfigurationsänderungen versioniert sowie zwischen Entwicklungs-, Test- und Produktionsworkspaces transportiert werden. Source Control für Data Agents ist aktuell noch Preview.
Lassen sich Data Agents automatisiert testen?
Ja. Über den Python SDK können Ground-Truth-Fragen mit erwarteten Antworten definiert und automatisiert gegen einen Data Agent evaluiert werden. Die Funktion befindet sich derzeit in Preview.
Ist der Fabric Data Agent selbst noch Preview?
Nein. Fabric Data Agents werden in der aktuellen Microsoft-Dokumentation als Generally Available geführt. Mehrere ergänzende Entwickler- und Betriebsfunktionen befinden sich aber weiterhin in Preview.